AI资讯新闻榜单内容搜索-Diffusion

AITNT-国内领先的一站式人工智能新闻资讯网站
# 热门搜索 #
搜索: Diffusion
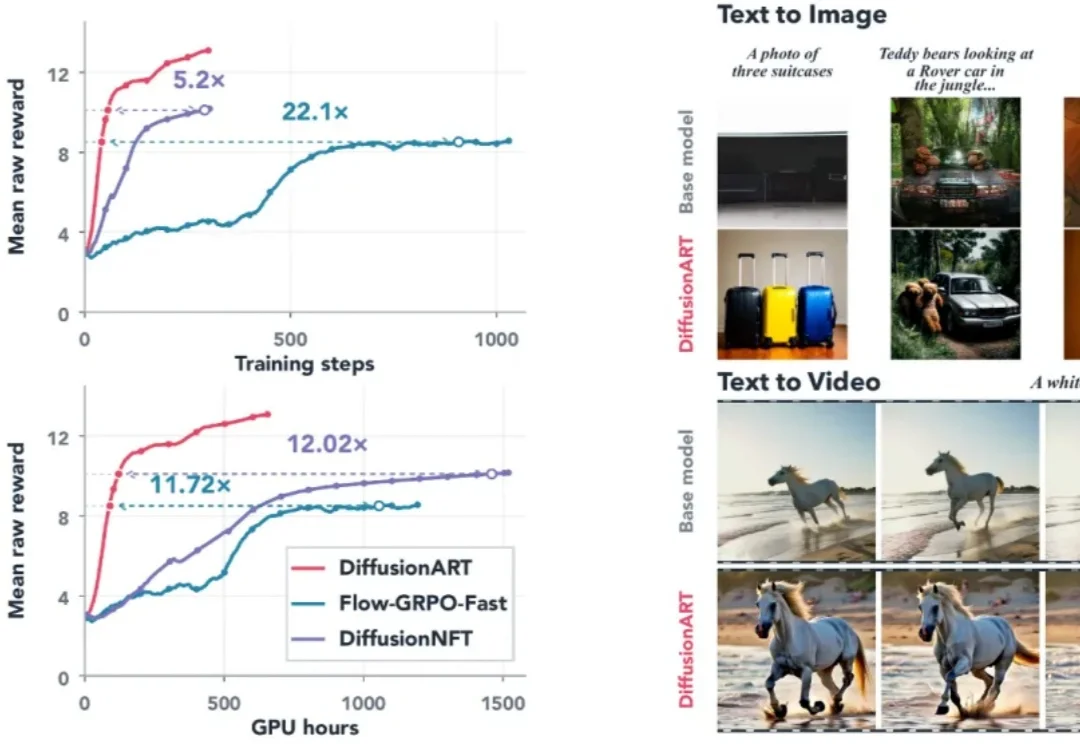
新国立x可灵AI提出DiffusionART:超高效稳定可扩展的Diffusion RL算法,让视频后训练提速10倍以上

新国立x可灵AI提出DiffusionART:超高效稳定可扩展的Diffusion RL算法,让视频后训练提速10倍以上

新国立x可灵AI提出DiffusionART:超高效稳定可扩展的Diffusion RL算法,让视频后训练提速10倍以上

来自新加坡国立大学、可灵 AI 和香港科技大学的研究团队提出了 DiffusionART,一种面向图像和视频生成的在线 Diffusion RL 算法。该方法支持采用 ODE 采样,不要求奖励模型可微,也无需额外调参,可自然适配标量奖励、二值偏好奖励等多种奖励形式,具有极高的样本效率。

来自主题: AI技术研报
8100 点击    2026-10-30 10:54
EMNLP'26 | 清华北邮联合警告:扩散式VLM的安全防线步步失守

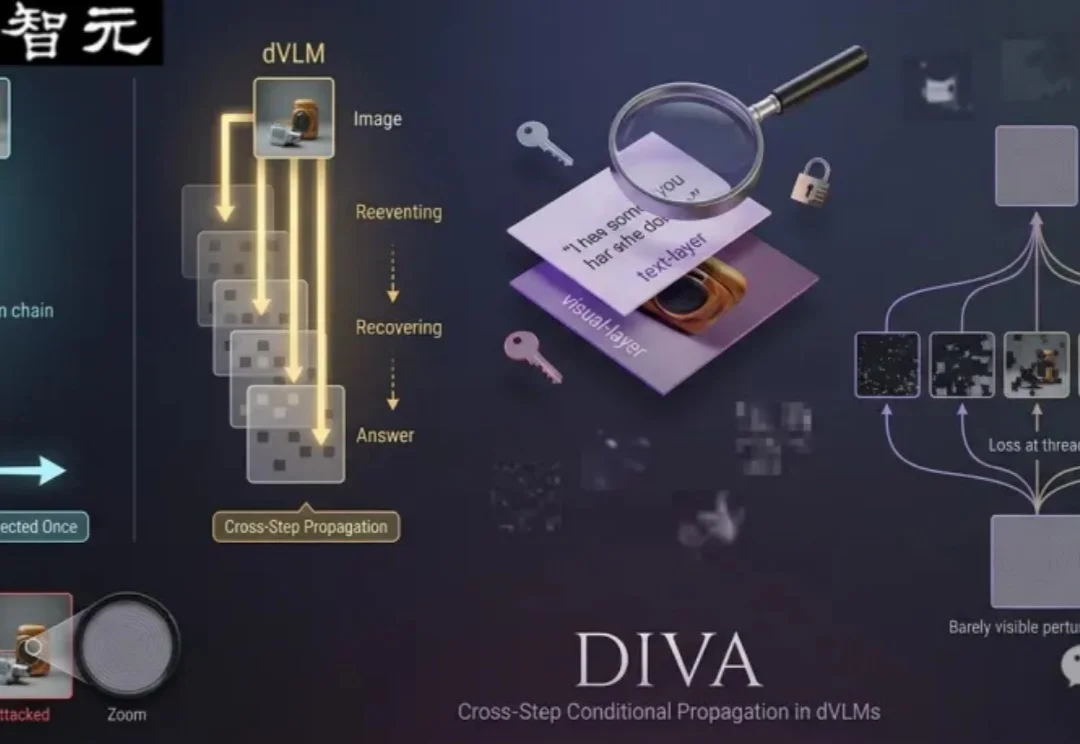
EMNLP'26 | 清华北邮联合警告:扩散式VLM的安全防线步步失守

EMNLP'26 | 清华北邮联合警告:扩散式VLM的安全防线步步失守

视觉语言模型已经进入办公助手、内容审核、机器人和智能终端等场景。

来自主题: AI技术研报
8058 点击    2026-10-16 10:53
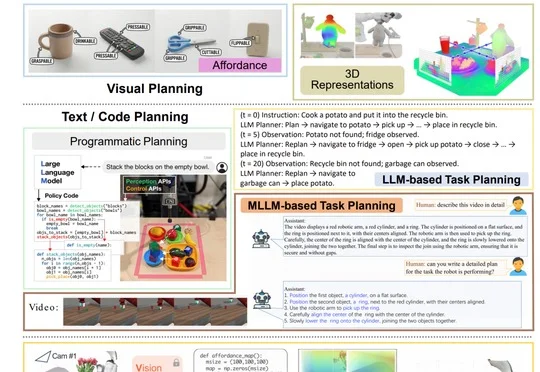
T-RO综述重构Foundation Model时代机器人操作知识版图

T-RO综述重构Foundation Model时代机器人操作知识版图

T-RO综述重构Foundation Model时代机器人操作知识版图

过去几年,机器人操作领域几乎被一批新概念重新 “刷屏”。 LLM Planner、VLA、Diffusion Policy、Flow Matching、Latent Action、World Mode

来自主题: AI技术研报
8971 点击    2026-09-04 15:48
MiniMax H3 团队 Reddit 上回应一切:2K 要开源,图像模型在路上,Apache 2.0 也在考虑了

MiniMax H3 团队 Reddit 上回应一切:2K 要开源,图像模型在路上,Apache 2.0 也在考虑了

MiniMax H3 团队 Reddit 上回应一切:2K 要开源,图像模型在路上,Apache 2.0 也在考虑了

8 月 7 日晚上 10 点,MiniMax H3 团队来到 Reddit 的 r/StableDiffusion 社区举行 AMA(Ask Me Anything)。参与此次交流的包括 H3 研究负责人 dacongya,研究员 Luigi、Nero、Kiro,系统工程师 Reynor,以及 MiniMax 开发者关系负责人 Ryanlee。

来自主题: AI资讯
10448 点击    2026-08-08 19:36
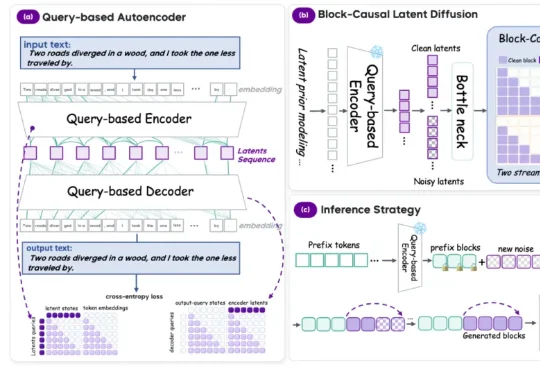
继何恺明团队ELF后,南京大学基于昇腾算力同步提出连续扩散语言模型

继何恺明团队ELF后,南京大学基于昇腾算力同步提出连续扩散语言模型

继何恺明团队ELF后,南京大学基于昇腾算力同步提出连续扩散语言模型

近日来自南京大学模式识别实验室(PRLab)的梁嘉骏、廖宇程,在司晨阳教授的指导下,联合新加坡南洋理工大学、英国帝国理工学院,提出连续扩散语言模型 AURORA-LM(Autoencoding Unified Representation for Continuous-Latent Diffusion Language Modeling),对连续空间下的语言建模作出了更多的思考和发现。

来自主题: AI技术研报
8774 点击    2026-08-08 13:15
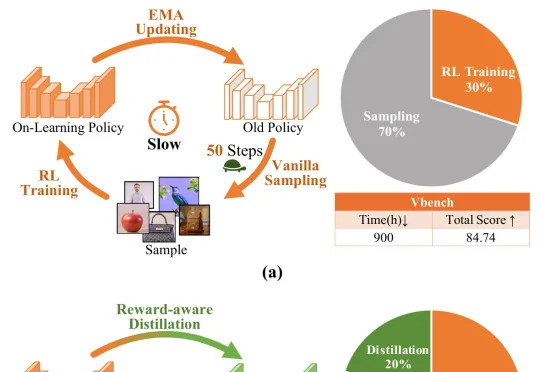
ICML 2026 | 我们让蒸馏模型当了采样器,Diffusion RL采样成本降低一个数量级

ICML 2026 | 我们让蒸馏模型当了采样器,Diffusion RL采样成本降低一个数量级

ICML 2026 | 我们让蒸馏模型当了采样器,Diffusion RL采样成本降低一个数量级

过去的 Diffusion RL 多聚焦于奖励设计与优化算法,训练时的采样成本被忽视。DMSampler 指出:在在线 RL 中,限制规模化的不只是奖励信号或优化器,很多时候是 rollout 本身太贵。

来自主题: AI技术研报
8766 点击    2026-08-01 10:44
上海交大提出ICRDrag:首个上下文区域拖拽模型,实现精准可控图像编辑

上海交大提出ICRDrag:首个上下文区域拖拽模型,实现精准可控图像编辑

上海交大提出ICRDrag:首个上下文区域拖拽模型,实现精准可控图像编辑

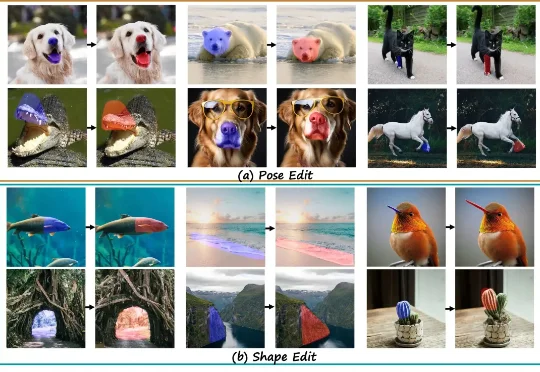
还在用 DragGAN、DragDiffusion 拖拽修图?点选拖拽容易变形、边界割裂、细节丢失的时代落幕了!ECCV 2026 ICRDrag 首创上下文区域拖拽模型,用掩码精准定位局部区域,移动、缩放、变形全都丝滑自然,兼顾精准度与画面真实感。

来自主题: AI技术研报
8818 点击    2026-07-05 09:47
扩散模型里的噪声,原来还有这样的作用:DRDD重新定义统一图像翻译

扩散模型里的噪声,原来还有这样的作用:DRDD重新定义统一图像翻译

扩散模型里的噪声,原来还有这样的作用:DRDD重新定义统一图像翻译

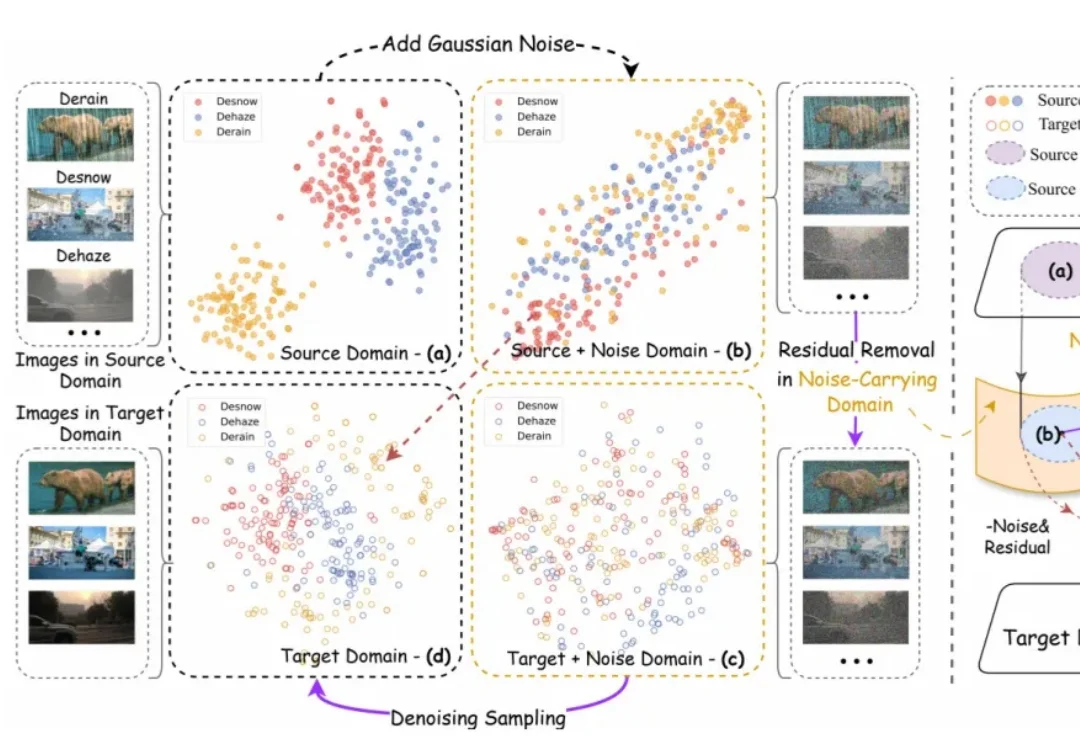
在图像到图像翻译(Image-to-Image Translation, I2I)这个任务上,扩散模型过去几年几乎形成了一套默认逻辑:先把输入图像和噪声混合,再一步步去噪,把目标图像 “还原” 出来。

来自主题: AI技术研报
17719 点击    2026-06-10 15:15
ICML 2026|文生图模型也会「忘词」?复旦创智等提出Prompt Reinjection,无需训练提升文生图指令遵循能力

ICML 2026|文生图模型也会「忘词」?复旦创智等提出Prompt Reinjection,无需训练提升文生图指令遵循能力

ICML 2026|文生图模型也会「忘词」?复旦创智等提出Prompt Reinjection,无需训练提升文生图指令遵循能力

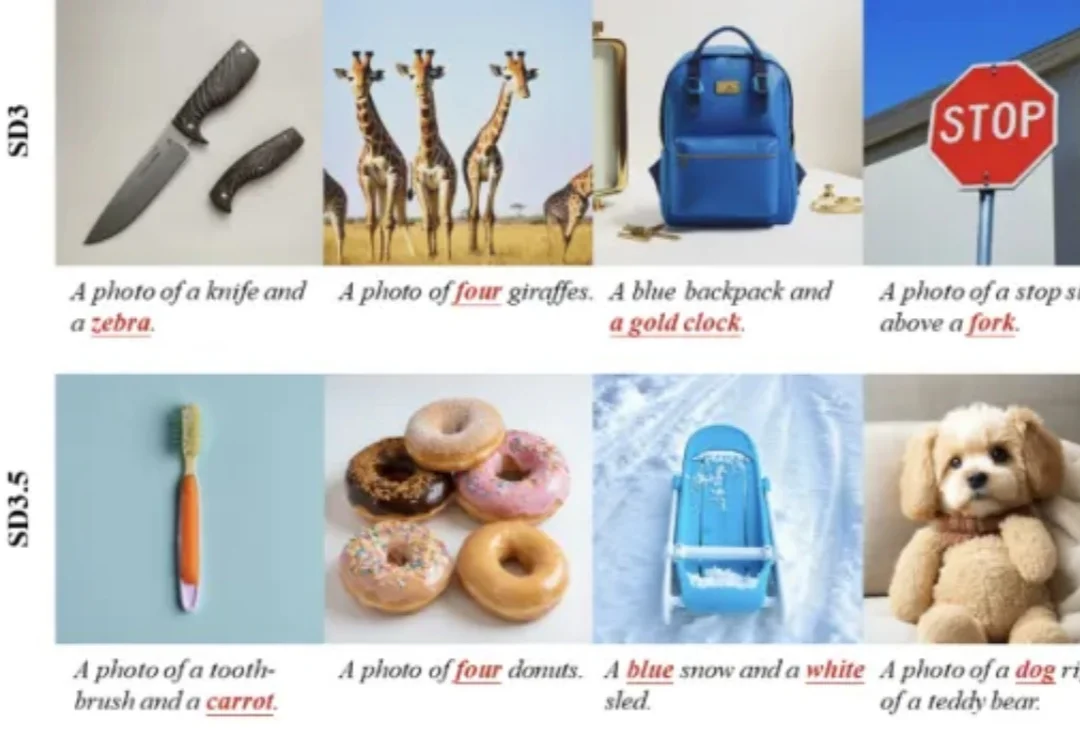
近年来,文生图模型的能力快速提升。从 Stable Diffusion 到 FLUX、Qwen-Image,扩散模型已经能够生成高质量图像,也能处理越来越复杂的文本提示。

来自主题: AI技术研报
11469 点击    2026-06-09 10:02